Alibaba й далі активно розвиває напрям відкритого штучного інтелекту: підрозділ Qwen випустив нову модель Qwen-Image-2.1 для створення та редагування зображень із відкритими вагами. За словами розробників, вона перевершує більшість закритих конкурентів, попри те, що має лише 7 мільярдів параметрів. Про появу моделі написав The Decoder, а технічні подробиці опублікував офіційний блог Qwen.
Компактність замість гігантизму
Головна ідея цього релізу полягає не в тому, щоб зробити модель більшою, а навпаки — суттєво зменшити її розмір без втрати якості. Візуальний генеративний блок Qwen-Image-2.1 складається з 32 шарів Single-Stream DiT і має лише 7 млрд параметрів — це втричі менше, ніж 20 млрд у попередника, Qwen-Image 1.0.
При цьому нова версія об'єднує в єдиному пайплайні цілий набір можливостей:
- створення зображень за текстовим описом
- редагування вже наявних зображень
- нативна підтримка прозорих зображень у форматі RGBA — модель може генерувати графіку з прозорим фоном або вирізати об'єкт із фотографії на окремий прозорий шар
- одночасна робота з десятьма референсними зображеннями — корисно для групових портретів, віртуальної примірки одягу чи інтер'єрного дизайну
- локальне редагування за допомогою кіл, масок або позначок, намальованих від руки
Крім того, модель нативно генерує зображення у роздільній здатності 2K, а розробники стверджують, що покращили роботу з типографікою та світлотінню на портретах.
Швидкість завдяки архітектурним рішенням
Прискорення обчислень, особливо коли модель працює з кількома референсними зображеннями одночасно, забезпечує змішана гранулярність уваги (mixed-granularity attention) разом із повторним використанням KV-кешу префіксу. Простими словами, текстові команди та вхідні зображення обробляються й запам'ятовуються лише один раз на першому кроці, а не перераховуються заново на кожному наступному — це помітно знижує навантаження під час мультиреференсного редагування.
Завдяки цій оптимізації модель здатна функціонувати навіть на потужних споживчих відеокартах — розробники наводять як приклад GeForce RTX 3090.
Сьоме місце загалом, перше серед відкритих моделей
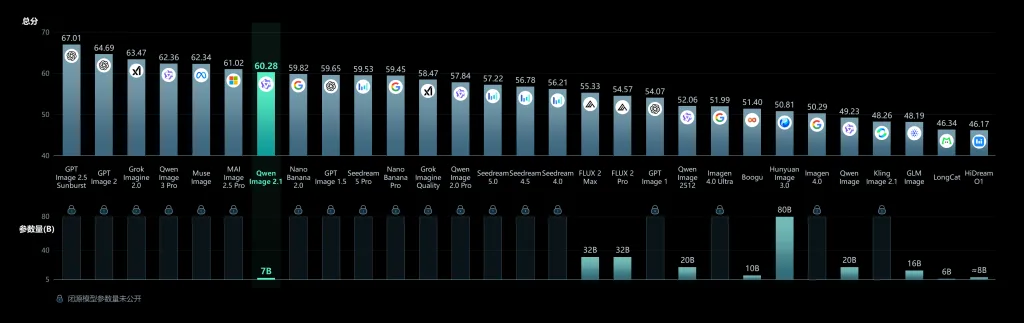
У внутрішньому бенчмарку Qwen-Image-Bench модель набрала 60,28 бала, що відповідає сьомому місцю серед 29 протестованих систем. Вище неї розташувалися шість закритих рішень, а лідером став GPT Image 2.5 Sunburst із результатом 67,01.
Водночас Qwen-Image-2.1 обійшла Nano Banana 2.0, яка набрала 59,82 бала, і випередила абсолютно всі відкриті моделі в переліку — включно з набагато більшою FLUX 2 Max, що має 32 млрд параметрів.
Варто враховувати, що бенчмарк власний і поки не пройшов перевірку незалежними тестами, а кількість параметрів у закритих конкурентів не розкривається, тож коректно порівнювати розмір моделей можна лише серед відкритих рішень.
Доступ відкритий, але з обмеженням щодо бізнесу
Модель уже опублікована на Hugging Face, GitHub і Model Scope, де також можна протестувати демоверсію. Проте ліцензія має дослідницький характер і прямо забороняє комерційне застосування — компаніям, які хочуть використовувати Qwen-Image-2.1 у бізнесі, доведеться окремо звертатися до Qwen за комерційною угодою.
Дискусія на Hacker News
Обговорення релізу на Hacker News зібрало десятки коментарів, і найбільше уваги привернуло саме питання ліцензування. Користувач jfoster зауважив, що попередні моделі Qwen зазвичай виходили під ліцензією Apache, тоді як нова версія має значно суворіші умови.
Коментатор gregoriol підтвердив цю тенденцію, зазначивши, що останні опенсорсні моделі для генерації зображень із ліцензією Apache 2.0 з'являлися ще у 2025 році, а тепер у Qwen нормою стало саме некомерційне використання. Той-таки jfoster додав, що текст ліцензії прямо забороняє застосування матеріалів у комерційних цілях без окремої угоди, тож у результаті вартість використання моделі залежатиме від рішень Alibaba, а не лише від витрат на хмарну інфраструктуру.
Знайшлися й гостріші критичні відгуки: користувач gunalx зауважив, що нова відкрита модель навіть не перевершує власну закриту розробку компанії — Qwen3 Image, яка вже встигла застаріти.
Проте загальна атмосфера в обговоренні лишилася доброзичливою. Коментатор d2kx назвав команду Qwen «найрізноманітнішою» серед усіх китайських лабораторій, зауваживши, що конкурувати з нею здатна хіба Gemini/DeepMind.
Якби це залежало від американців, нам довелося б платити шалені гроші за доступ через API.
hgufj, користувач Hacker News
Технічна частина дискусії зосередилась навколо запуску моделі на власному обладнанні — учасники обговорювали варіанти через ComfyUI, vLLM, SGLang та diffusion.cpp, оскільки стандартний llama.cpp досі не підтримує генерацію зображень безпосередньо.
Один із коментаторів під ніком trains39472 із захопленням написав, що 7-мільярдна дифузійна модель тепер рендерить китайські, японські й корейські ієрогліфи краще, ніж це вдається самій Windows.
Були й скептичні голоси: користувач BlackGlory звернув увагу на характерний жовтуватий відтінок згенерованих зображень — так званий «piss filter», який зазвичай асоціюють із ChatGPT, натякнувши, що модель могла бути дистильована із зображень конкурента. Однак це припущення так і лишилося без підтвердження.
Натомість коментатор trentor відзначив протилежне: на його думку, у Qwen нарешті «полагодили VAE», проблема з яким роками стримувала якість зображень у попередніх версіях моделі.
Раніше повідомлялося, що під час одного з експериментів локальна модель Qwen 3.5-9B впоралася з 95% робочих задач розробника.
Джерело: Highload.tech


