Клієнту трекінг здається елементарним: вписав номер — побачив, де зараз коробка. У розробника картина зовсім інша. За одним статусом можуть ховатися кілька перевізників, окремі API, webhooks, черги подій, повторні спроби запитів, перетворення статусів і дані, що приходять із запізненням.
Міжнародна посилка — це, по суті, розподілена система. Вона одночасно рухається фізично між складами й країнами та лишає цифровий слід із різних незалежних джерел, і ці два процеси майже завжди трохи розходяться в часі. Варто розібратися, що відбувається між сканером на складі й повідомленням, яке зрештою бачить користувач у застосунку.
Номер посилки — це ключ до подій, а не координати GPS
Головна помилка — думати, що tracking number показує позицію вантажу в реальному часі. Насправді це радше ідентифікатор, прив'язаний до набору окремих подій: сканування під час приймання, проходження сортувального центру, передача іншому оператору. Між цими подіями коробка легко подолає сотні кілометрів, не породивши жодного нового запису.
Тому фраза «статус не оновлювався 12 годин» не означає, що вантаж стоїть на місці. У базовому варіанті система фіксує tracking ID, перевізника, тип події, час, локацію, а також сирий і нормалізований статус.
Один маршрут — це насправді кілька різних API
У межах США посилку може вести один оператор. Далі, потрапивши на форвардинговий склад, вона стає частиною міжнародного відправлення, а в Україні останню милю вже часто виконує зовсім інша служба. У кожного учасника ланцюга — своя модель даних: хтось повертає delivered, хтось DEL, а хтось текстове повідомлення про доставку одержувачу.
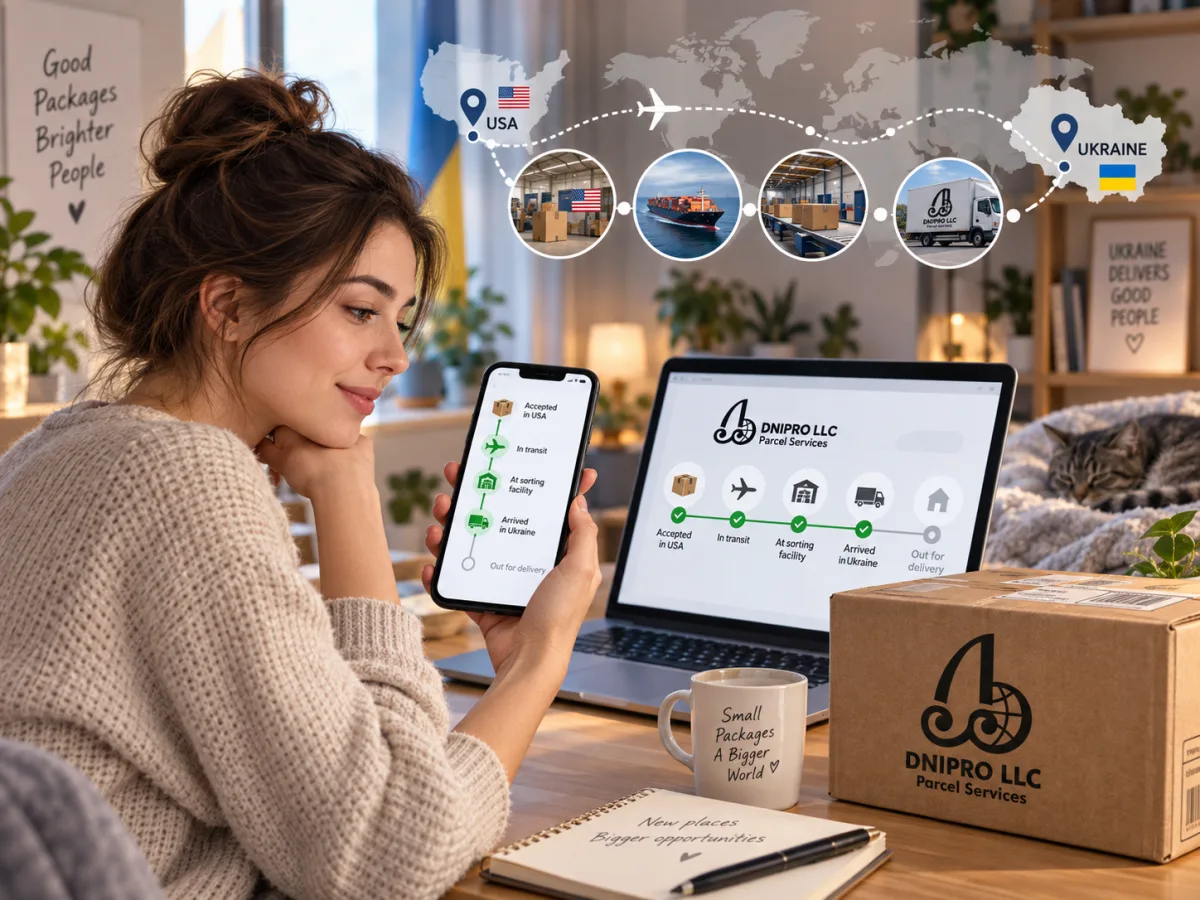
Якщо віддавати користувачу ці сирі значення напряму, інтерфейс перетвориться на словник кодів. Саме тому між зовнішніми API та frontend потрібен окремий шар нормалізації, який зводить десятки подій до кількох зрозумілих станів: Created, Accepted, In transit, At warehouse, Customs, Out for delivery, Delivered, Exception. Від якості цього мапінгу залежить, чи зрозуміє людина, що відбувається з її посилкою.
Webhook проти опитування: як система дізнається про нову подію
У найкращому випадку перевізник сам надсилає webhook щоразу, коли з'являється нова подія: система приймає payload, перевіряє його, зберігає й оновлює загальний статус. Але не всі партнери однаково зручні — у когось є лише REST API, а партнерський інтерфейс може обмежувати кількість запитів (rate limits). У такому разі доводиться опитувати систему самостійно (polling).
Наївний підхід — перевіряти всі номери кожні п'ять хвилин. На малих обсягах це ще працює, але на великих масштабах більшість таких запитів не приносить нічого нового. Ефективніше прив'язувати частоту опитування до стану відправлення: щойно створену етикетку можна перевіряти рідше, статус «Out for delivery» — частіше, а доставлені посилки взагалі виключити з активного опитування.
Події приходять не в тому порядку, в якому сталися
Уявімо, що подія на сортувальному центрі сталася о 10:02, а наступне сканування — о 10:17. Через мережеву затримку друга подія може дістатися системи першою. Якщо просто оновлювати поле статусу в порядку надходження HTTP-запитів, посилку можна ненавмисно «відкинути» назад у часі.
Тому варто розділяти щонайменше два часових позначки: event_time — момент, коли подія відбулася насправді, і received_at — коли її отримала система. Слід також враховувати дублювання: webhook може прийти двічі, партнер повторить запит після таймауту, а polling витягне подію, яку система вже одержала іншим шляхом. Без ідемпотентності одна фізична дія перетворюється на кілька зайвих push-повідомлень.
Ідемпотентність потрібна не тільки для платежів
Для подій трекінгу корисно мати зовнішній ідентифікатор події або власний ключ дедуплікації — наприклад, комбінацію номера посилки, типу події, часу та локації. Це критично, якщо на статус підписані ще й інші процеси.
Подія «прибуття на склад» може одночасно оновлювати кабінет клієнта, генерувати push-повідомлення, створювати задачу для складу і змінювати список посилок, доступних для консолідації. Якщо весь цей ланцюг випадково виконається двічі, наслідки вже не будуть суто косметичними.
Чому eventual consistency — це нормальний стан речей
Користувачу хочеться, щоб фізичний рух посилки й дані в застосунку збігалися до секунди, але в логістиці це майже неможливо. Сканер може працювати офлайн, API партнера — віддавати дані із затримкою, webhook — потрапити в черзі повторних спроб, а сам застосунок — кешувати попередній стан.
Тому система здебільшого є eventually consistent: із часом усі компоненти сходяться до правильної картини, але в конкретну секунду можуть показувати різні версії реальності. Проблема не в самій цій властивості, а в тому, коли продукт її не пояснює користувачу.
Замість категоричного твердження «Посилка на складі X» іноді чесніше й корисніше показати просте «Останнє оновлення: 14:32» — це одразу формує правильні очікування.
Черга між інтеграцією та бізнес-логікою
Якщо webhook напряму й синхронно запускає всю бізнес-логіку, зовнішній партнер фактично диктує, наскільки швидко має відповідати ваш endpoint. Надійніша архітектура виглядає так: перевізник передає дані на webhook endpoint, той після перевірки кладе подію в черзю, звідки її забирає обробник подій, записує в базу даних і вже потім запускає сповіщення.
Endpoint у такій схемі лише швидко приймає валідну подію, а нормалізація, дедуплікація, перерахунок статусу й розсилка push виконуються асинхронно. Це дає змогу коректно повторювати спроби, контролювати навантаження (backpressure) і простіше опрацьовувати помилки. Для проблемних payload корисна dead-letter queue — вони не зникають безслідно і не блокують основний потік обробки.
Чому статус «створено етикетку» може висіти кілька днів
Класична ситуація: магазин створює shipping label і передає tracking number покупцю. API перевізника вже знає про цей номер, тож система показує «Label created» — хоча самої коробки в перевізника фізично ще немає. Магазин може віддати її ввечері, наступного дня чи навіть після вихідних, а перший реальний скан з'явиться лише під час приймання.
З технічного погляду тут усе працює правильно, але з погляду продукту користувач бачить номер і думає, що доставка вже почалася. Тому статуси краще формулювати мовою дії — фраза «Магазин створив етикетку, очікуємо передачу перевізнику» точніша, ніж абстрактне «Відправлено».
Спостережуваність важлива не менше за сам трекінг
Якщо система об'єднує кілька carrier API, звичайного логування 500-ї помилки вже не вистачає. Варто окремо стежити за затримкою між event_time і received_at, кількістю номерів без оновлень довше встановленого порогу, частотою кодів 429 і 5xx від партнерів, розміром retry queue та кількістю статусів, для яких ще не прописано мапінг.
Особливо показовий саме показник затримки (lag): якщо lag подій від одного партнера раптово зріс з кількох хвилин до сорока, користувачі можуть цього ще не помітити, але інцидент уже фактично почався.
Інтерфейс — це останній, але не менш важливий шар архітектури
Можна побудувати ідеальний ingestion pipeline і все одно отримувати сотні звернень «де моя посилка?». Причина проста: людині не потрібні внутрішні типи подій системи. Їй потрібна відповідь лише на три питання — що вже сталося, де посилка зараз і що буде далі.
Шлях покупки зі США може включати магазин, американського перевізника, склад, авіа- чи морське перевезення, митний етап і локальну доставку в Україні. Завдання продукту — перетворити всю цю складність на один зрозумілий маршрут для людини.
Як приклад такого користувацького сценарію можна навести Dnipro LLC, де американська адреса, особистий кабінет, міжнародне відправлення і трекінг об'єднані в єдиний процес.
Для розробника трекінг посилок — гарний навчальний приклад роботи з розподіленими системами: тут є зовнішні API, події без чіткого порядку, дублікати, повторні спроби, eventual consistency, мапінг станів і людина, яка попри всю цю складність очікує лише одну просту відповідь. У цьому й полягає найцікавіша частина задачі — система може бути складною всередині, але для користувача вона повинна виглядати очевидною.
Джерело: Highload.tech