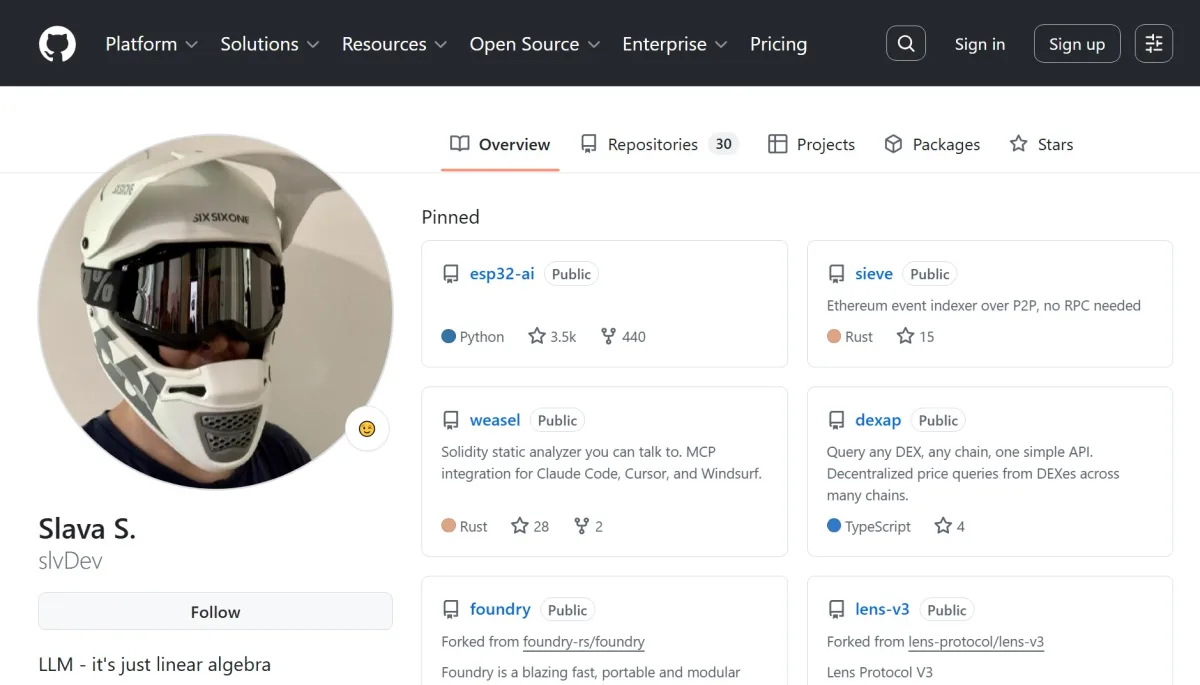
Розробник з Одеси, відомий на GitHub під псевдонімом slvDev, довів, що для роботи великої мовної моделі необов'язково мати потужну відеокарту чи повноцінний ПК. Його проєкт ESP32-AI запускає LLM із 28,9 мільйона параметрів безпосередньо на платі ESP32-S3, яка коштує менш ніж $10.
Як пише The Register, репозиторій проєкту вже зібрав 3,5 тисячі зірок на GitHub і 440 форків.
Як мовна модель поміщається у крихітний чіп
ESP32-S3 — не найпотужніше залізо: чіп має лише 512 КБ оперативної пам'яті SRAM, 8 МБ додаткової PSRAM і 16 МБ флеш-пам'яті. Тим часом сучасні мовні моделі зазвичай потребують десятків, а іноді й сотень гігабайтів, бо кожен параметр забирає від одного до чотирьох байтів.
Аби вкластися у настільки скромні ресурси, автор застосував жорстку 4-бітну квантизацію. Завдяки цьому готова модель важить лише 14,9 МБ і вільно вміщується у вбудовану флеш-пам'ять плати.
Головним технічним рішенням став метод Per-Layer Embeddings (PLE), який розробила Google. За словами автора проєкту, це перша відома спроба адаптувати цю техніку для настільки обмеженого обладнання.
До цього подібні експерименти з мовними моделями на мікроконтролерах не виходили за межі приблизно 260 тисяч параметрів. Новий проєкт перевершує ці показники більш ніж у сто разів.
Швидкість читання людини — без жодного підключення до хмари
За тестами автора, модель генерує текст зі швидкістю близько 9,88 токена на секунду, що перевищує середню швидкість читання людини. Усі обчислення відбуваються локально на самій платі — жодні дані не виходять за межі чипа, від навчання до генерації тексту.
Базову модель натренували на датасеті TinyStories від Microsoft, і вона вміє створювати короткі, доволі зв'язні історії. Окрім неї, розробник підготував другу модель під назвою Barista, яка відповідає на запитання, але лише про еспресо-каву, і працює приблизно вдвічі швидше за основну.
Чого від цієї моделі чекати не варто
Попри вражаючу технічну реалізацію, практичне застосування проєкту досить обмежене:
- модель не підходить для створення чат-бота
- вона не вміє писати код
- її не можна використати для побудови автономного ШІ-агента
- її можливості звужуються до генерації простих історій або, у випадку Barista, відповідей на вузьку тему
Автор виклав на GitHub повний код прошивки, скрипти для тренування моделі, конвеєр квантизації, схему підключення та результати власних експериментів — тож повторити проєкт може будь-хто охочий.
Хоч сам результат має скоріше демонстраційний, «іграшковий» характер, факт роботи повноцінної мовної моделі на платі вартістю $10 показує, наскільки просунулися технології стиснення ШІ-моделей. Це також натякає на потенціал використання флеш-пам'яті як багаторівневого сховища для ШІ-систем загалом.
Джерело: Highload.tech